 B2B Software Finder
엔터프라이즈 RAG의 환각을 최소화하려면 원본 문맥을 보존하는 문맥 주석 청킹, BM25와 벡터를 결합한 하이브리드 검색 및 교차 인코더 리랭킹, 컨텍스트 기반 답변만 허용하는 엄격한 가드레일, 그리고 RAG 트라이어드 기반 정량 평가 파이프라인을 필수적으로 갖추어야 합니다.
1. 엔터프라이즈 RAG에서 환각이 발생하는 근본 원인과 단순 벡터 검색의 한계
많은 기업이 사내 Confluence 위키, 사규집, Jira 티켓, 업무 매뉴얼 등 방대한 비정형 문서를 거대언어모델(LLM)에 연결하는 검색증강생성(RAG, Retrieval-Augmented Generation) 시스템을 도입하고 있습니다. 그러나 파일럿 단계를 넘어 실제 업무에 배포했을 때 가장 빈번하게 부딪히는 장벽은 생성형 AI가 그럴듯하지만 완전히 잘못된 정보를 생성하는 환각(Hallucination) 현상입니다. 사내 문서는 일반 웹 문서와 달리 프로젝트 코드명, 부서별 축약어, 유사한 제품 모델 번호, 그리고 수시로 갱신되는 개정 이력이 얽혀 있어 정보의 밀도가 극도로 높습니다. 이러한 환경에서 시스템이 질문과 직접 연관되지 않거나 과거 버전의 문서를 검색해 오면 모델은 전달받은 불완전한 문맥을 바탕으로 추론을 시도하다 사실을 왜곡하게 됩니다.
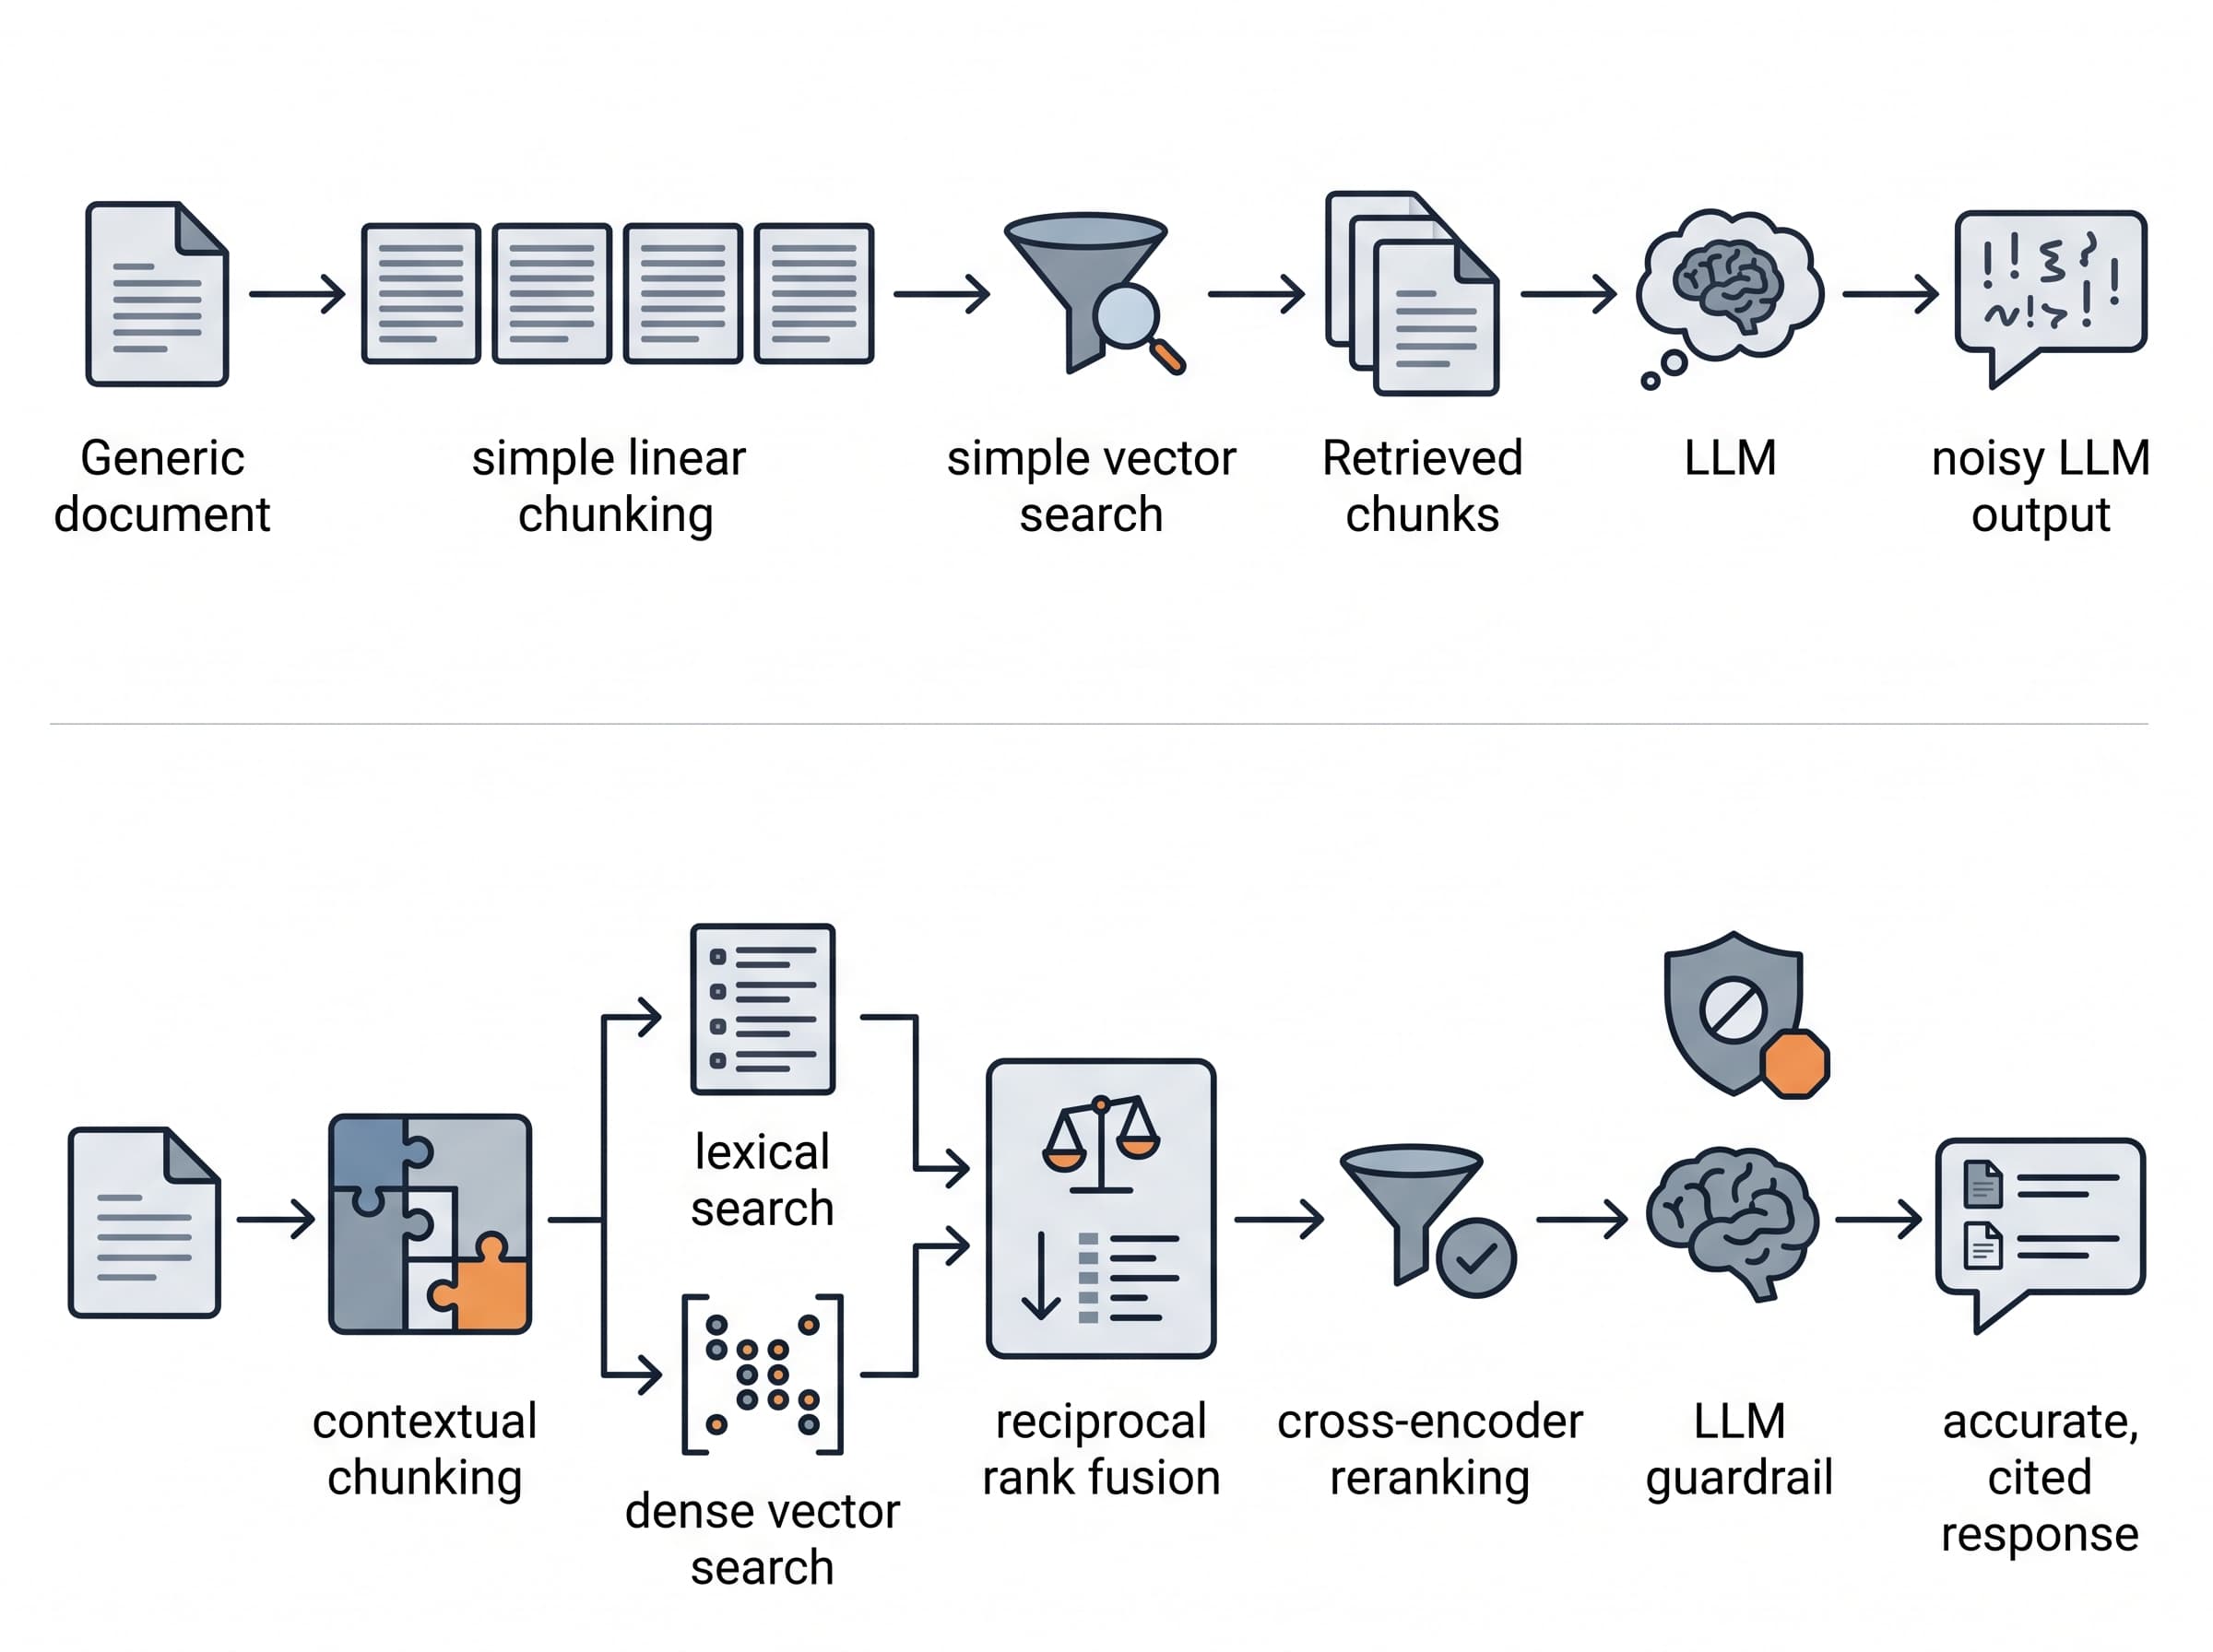
시중의 수많은 RAG 튜토리얼이 제안하는 '텍스트 분할 후 임베딩(Embedding) 벡터 유사도 검색' 방식은 기업 실무 환경에서 심각한 구조적 결함을 드러냅니다. 긴 문서를 500자나 1,000자 단위의 고정 크기 청크(Chunk)로 기계적으로 자르면, 특정 청크가 속했던 상위 문서의 제목, 목차 계층, 작성 부서, 유효 일자 같은 핵심 배경 정보가 완전히 증발합니다. LlamaIndex의 청크 크기 평가 연구(Evaluating the Ideal Chunk Size for a RAG System using LlamaIndex)에 따르면, 지나치게 작거나 부적절한 고정 크기 분할은 필수 정보가 상위 검색 결과에서 누락되는 문맥 결손을 초래하며, 이는 생성 모델의 충실도(Faithfulness, 환각 부재)와 관련성(Relevancy)을 직접적으로 떨어뜨립니다 2. 또한 밀집 벡터 임베딩(Dense Vector Embedding)은 단어의 포괄적인 의미적 유사성은 잘 포착하지만, 사내 규정 조항 번호나 특정 에러 코드, 고유명사처럼 글자 하나만 틀려도 결과가 완전히 달라지는 키워드를 정밀하게 식별하지 못합니다. 결과적으로 생성 모델에 노이즈 청크가 전달되고, 모델은 누락된 세부 정보를 자체 파라미터 지식으로 메우려다 치명적인 환각을 유발합니다.
2. 데이터 전처리 및 문맥 보존 청킹(Contextual Chunking) 설계
RAG 파이프라인의 정확도를 결정하는 첫 단추는 텍스트를 벡터 데이터베이스에 넣기 전 거치는 전처리 파이프라인입니다. 기존의 단순 청킹은 문단을 무작위로 절단하여 '해당 조항은 전년도 매출액 50억 원 이상 사업장에만 적용된다'는 본문에서 '전년도 매출액 50억 원 이상 사업장'이라는 조건절만 독립된 청크로 분리되어 주어와 술어가 상실되는 문제를 일으켰습니다. 이를 극복하기 위해 제안된 혁신적 기법이 '문맥 주석 청킹(Contextual Chunking)'입니다. 이 방식은 문서를 개별 청크로 분할한 직후 소형 경량 언어모델을 활용해 해당 청크가 원본 문서 전체에서 어떤 위치와 주제를 가지는지 50자 내외의 설명 문맥(Context Header)을 청크 상단에 자동으로 덧붙인 뒤 임베딩 및 인덱싱을 수행합니다 1.
사내 위키와 규정집에는 복잡한 다단 표(Table), 불릿 리스트, 콜아웃 블록, 하이퍼링크가 다수 포함되어 있습니다. 이를 일반 텍스트 추출기로 변환하면 표의 행과 열 관계가 평탄화(Flatten)되어 숫자와 항목의 매핑이 뒤엉키게 됩니다. 따라서 전처리 파이프라인에는 HTML 구조나 마크다운(Markdown) 계층을 인식하는 구조화 파서(Parser)를 도입해야 합니다. 표 데이터의 경우 표 제목과 각 행의 헤더 정보를 포함한 마크다운 표 형식으로 변환하거나 각 행을 자연어 문장으로 풀어 인덱싱해야 검색 단계에서 수치 오류를 원천 차단할 수 있습니다. 또한 문서의 작성일자, 승인 상태, 담당 조직 코드를 메타데이터로 추출하여 메타데이터 필터링과 결합하는 작업이 수반되어야 합니다.
3. 하이브리드 검색과 2단계 교차 인코더(Cross-Encoder) 리랭킹
검색 정확도를 획기적으로 끌어올리는 표준 아키텍처는 밀집 벡터 검색(Dense Vector Search)과 키워드 기반 희소 검색(Sparse Search)을 결합한 '하이브리드 검색(Hybrid Search)'입니다. 고밀도 벡터 임베딩은 '육아휴직 신청 절차'라는 질의에 대해 본문에 '모성보호 휴가'나 '가사 돌봄 복지'라는 표현이 쓰여 있어도 의미적 맥락을 파악해 관련 문서를 찾아냅니다. 반면 'HR-POL-2024-03 조항'이나 'VPN 접속 오류 403-E'처럼 특정 고유 식별자나 전문 기술 용어를 찾는 질문에는 BM25 알고리즘 기반의 역색인 검색이 압도적으로 뛰어납니다. 하이브리드 검색은 두 방식의 검색 결과를 각각 수집한 뒤 역순위 결합(RRF, Reciprocal Rank Fusion) 알고리즘을 통해 점수를 정규화하고 합산함으로써 양쪽의 장점을 모두 취합니다 1.
하이브리드 검색으로 1차 선별된 상위 30~50개의 후보 청크를 곧바로 LLM의 컨텍스트 윈도우에 입력하는 것은 비효율적이며 오히려 환각의 빌미를 줍니다. 모델은 너무 많은 텍스트가 주어지면 문서의 중간에 위치한 주요 사실을 간과하는 '중간 소실(Lost in the Middle)' 현상을 겪기 때문입니다. 이를 해결하기 위해 필수적으로 배치해야 하는 컴포넌트가 '교차 인코더 리랭커(Cross-Encoder Reranker)'입니다. 1차 검색에 쓰이는 이중 인코더(Bi-Encoder)가 질문과 문서를 독립적으로 임베딩하여 거리를 계산하는 것과 달리, 교차 인코더는 사용자의 질문과 후보 문서를 단일 신경망에 함께 통과시켜 토큰 간의 상호 어텐션(Attention)을 계산합니다. Anthropic의 실증 연구에 따르면 문맥 주석 청킹과 하이브리드 검색, 리랭킹을 결합할 경우 청크 검색 실패율(retrieval failure rate)을 최대 67%까지 대폭 낮출 수 있습니다 1. (엔지니어링 팁: 해당 67% 감소 수치는 Top-20 청크 회수율 기준의 벤치마크이므로, 복잡한 다단 PDF나 비정형 표가 많은 엔터프라이즈 사내 문서의 특성에 따라 문맥 주석 생성을 위한 프롬프트 토큰 비용 및 실제 정확도 개선 폭에는 편차가 발생할 수 있음을 사전 검증해야 합니다.) 다만 이러한 고도화된 파이프라인의 검색 지연시간(Latency)은 벤치마크 환경(예: 10만 건 문서 코퍼스 기준, 엔비디아 T4/A10G GPU 인스턴스에서 BAAI의 bge-reranker-large(약 5억 6천만 파라미터) 또는 ms-marco-MiniLM-L-6-v2(약 2,270만 파라미터) 등 교차 인코더 서빙 시 약 250~450ms)에 따라 달라지며, 동시 질의량이나 CPU/GPU 하드웨어 구성에 따라 변동 폭이 큽니다. 파라미터 체급이 큰 500M+ 대형 리랭커는 미세한 문맥 일치도를 정밀하게 평가하지만 연산 부하가 큰 반면, 20M~30M 체급의 경량 리랭커는 처리 속도에서 이점을 가집니다. 프로덕션 환경에서 교차 인코더 리랭킹의 지연시간을 추가로 단축하기 위해서는 Triton Inference Server의 동적 배치(Dynamic Batching) 기능을 적용하거나 지식 증류(Distillation) 기반 경량화 리랭커 모델을 도입하는 실무 최적화가 강력히 권장됩니다.
| 비교 기준 | 단순 단일 벡터 검색 | 하이브리드 검색 (BM25 + Dense) | 문맥 주석 하이브리드 + 리랭킹 |
|---|---|---|---|
| 핵심 아키텍처 | 단일 고밀도 벡터 임베딩 및 코사인 유사도 검색 | BM25 어휘 검색과 벡터 검색 결과를 RRF로 결합 | 문맥 주석 청크 + 하이브리드 검색 후 Cross-Encoder 리랭킹 |
| 고유명사 및 코드 매칭력 | 낮음 (임베딩 공간 왜곡으로 유사 철자 혼동) | 높음 (BM25를 통한 정확한 토큰 매칭) | 매우 높음 (키워드 매칭 후 문맥 관련성 교차 검증) |
| 평균 검색 지연시간 (하드웨어/동시성 종속) | 50ms 내외 (1536차원 벡터 색인 기준, 매우 빠름) | 80~150ms 내외 (HNSW 및 BM25 병렬 처리 기준) | 250~450ms (5.6억 파라미터 체급 GPU 연산 부하 반영, 2,200만 체급 경량 모델 시 단축 가능) |
| 검색 실패율 개선 및 정확도 | 낮음 (노이즈 청크 다수 유입 위험) | 보통 (상위 랭킹 정밀도 한계 존재) | 최고 수준 (Anthropic 실증 기준 청크 검색 실패율 최대 67% 감소) 1 |
| 추천 적용 환경 | 단순 질의응답 PoC 및 개인 위키 | 중소규모 부서 문서 검색 시스템 | 미션 크리티컬 규정집, 사규, 기술 사양서 검색 |
4. LLM 가드레일과 인용 출처 역추적(Attribution) 강제 설계
검색 파이프라인을 아무리 정교하게 구축하더라도 생성 모델이 스스로 지어내려는 성향을 통제하지 못하면 무용지물이 됩니다. 엔터프라이즈 환경에서 환각을 방지하는 시스템 프롬프트의 대원칙은 '주어진 컨텍스트 외의 사전 지식을 절대 사용하지 말 것'과 '근거가 없으면 모른다고 명시적으로 답할 것(Strict Refusal)'입니다. 프롬프트에 사용자가 제공한 컨텍스트 블록의 범위를 명확한 구분자(XML 태그 등)로 감싸고, 답변에 포함되는 모든 주장 뒤에 반드시 참조한 문서명과 청크 ID를 브래킷 표기하도록 시스템 프롬프트에 강제해야 합니다. 모델이 자신의 답변이 어디에 근거하는지 스스로 연결 짓는 과정을 거칠 때(Chain-of-Verification) 비논리적인 도약과 환각이 현저히 감소합니다.
답변 생성 이후 사용자 인터페이스(UI)로 전달되기 직전에 작동하는 사후 가드레일(Post-generation Guardrail)도 필수적입니다. 경량 NLI(자연어 추론, Natural Language Inference) 모델이나 전용 규칙 엔진을 배치하여 생성된 응답의 각 문장이 검색된 컨텍스트 문장에 의해 의미론적으로 지지(Entailment)되는지, 모순(Contradiction)되는지, 중립(Neutral)인지를 판정합니다. 만약 검색 문서에 명시되지 않은 주장이 감지되면 사용자에게 경고 플래그를 노출하거나 안전한 대체 응답을 출력하도록 차단 파이프라인을 구성해야 합니다. 이와 함께 사용자가 챗봇의 답변 속 각 문장을 클릭했을 때 원본 문서의 정확한 문단 위치를 하이라이트 뷰어로 바로 띄워주는 역추적 링크를 제공하는 것이 신뢰도 확보의 핵심입니다.
5. RAG Triad 기반의 정량 평가 및 회귀 테스트 프레임워크
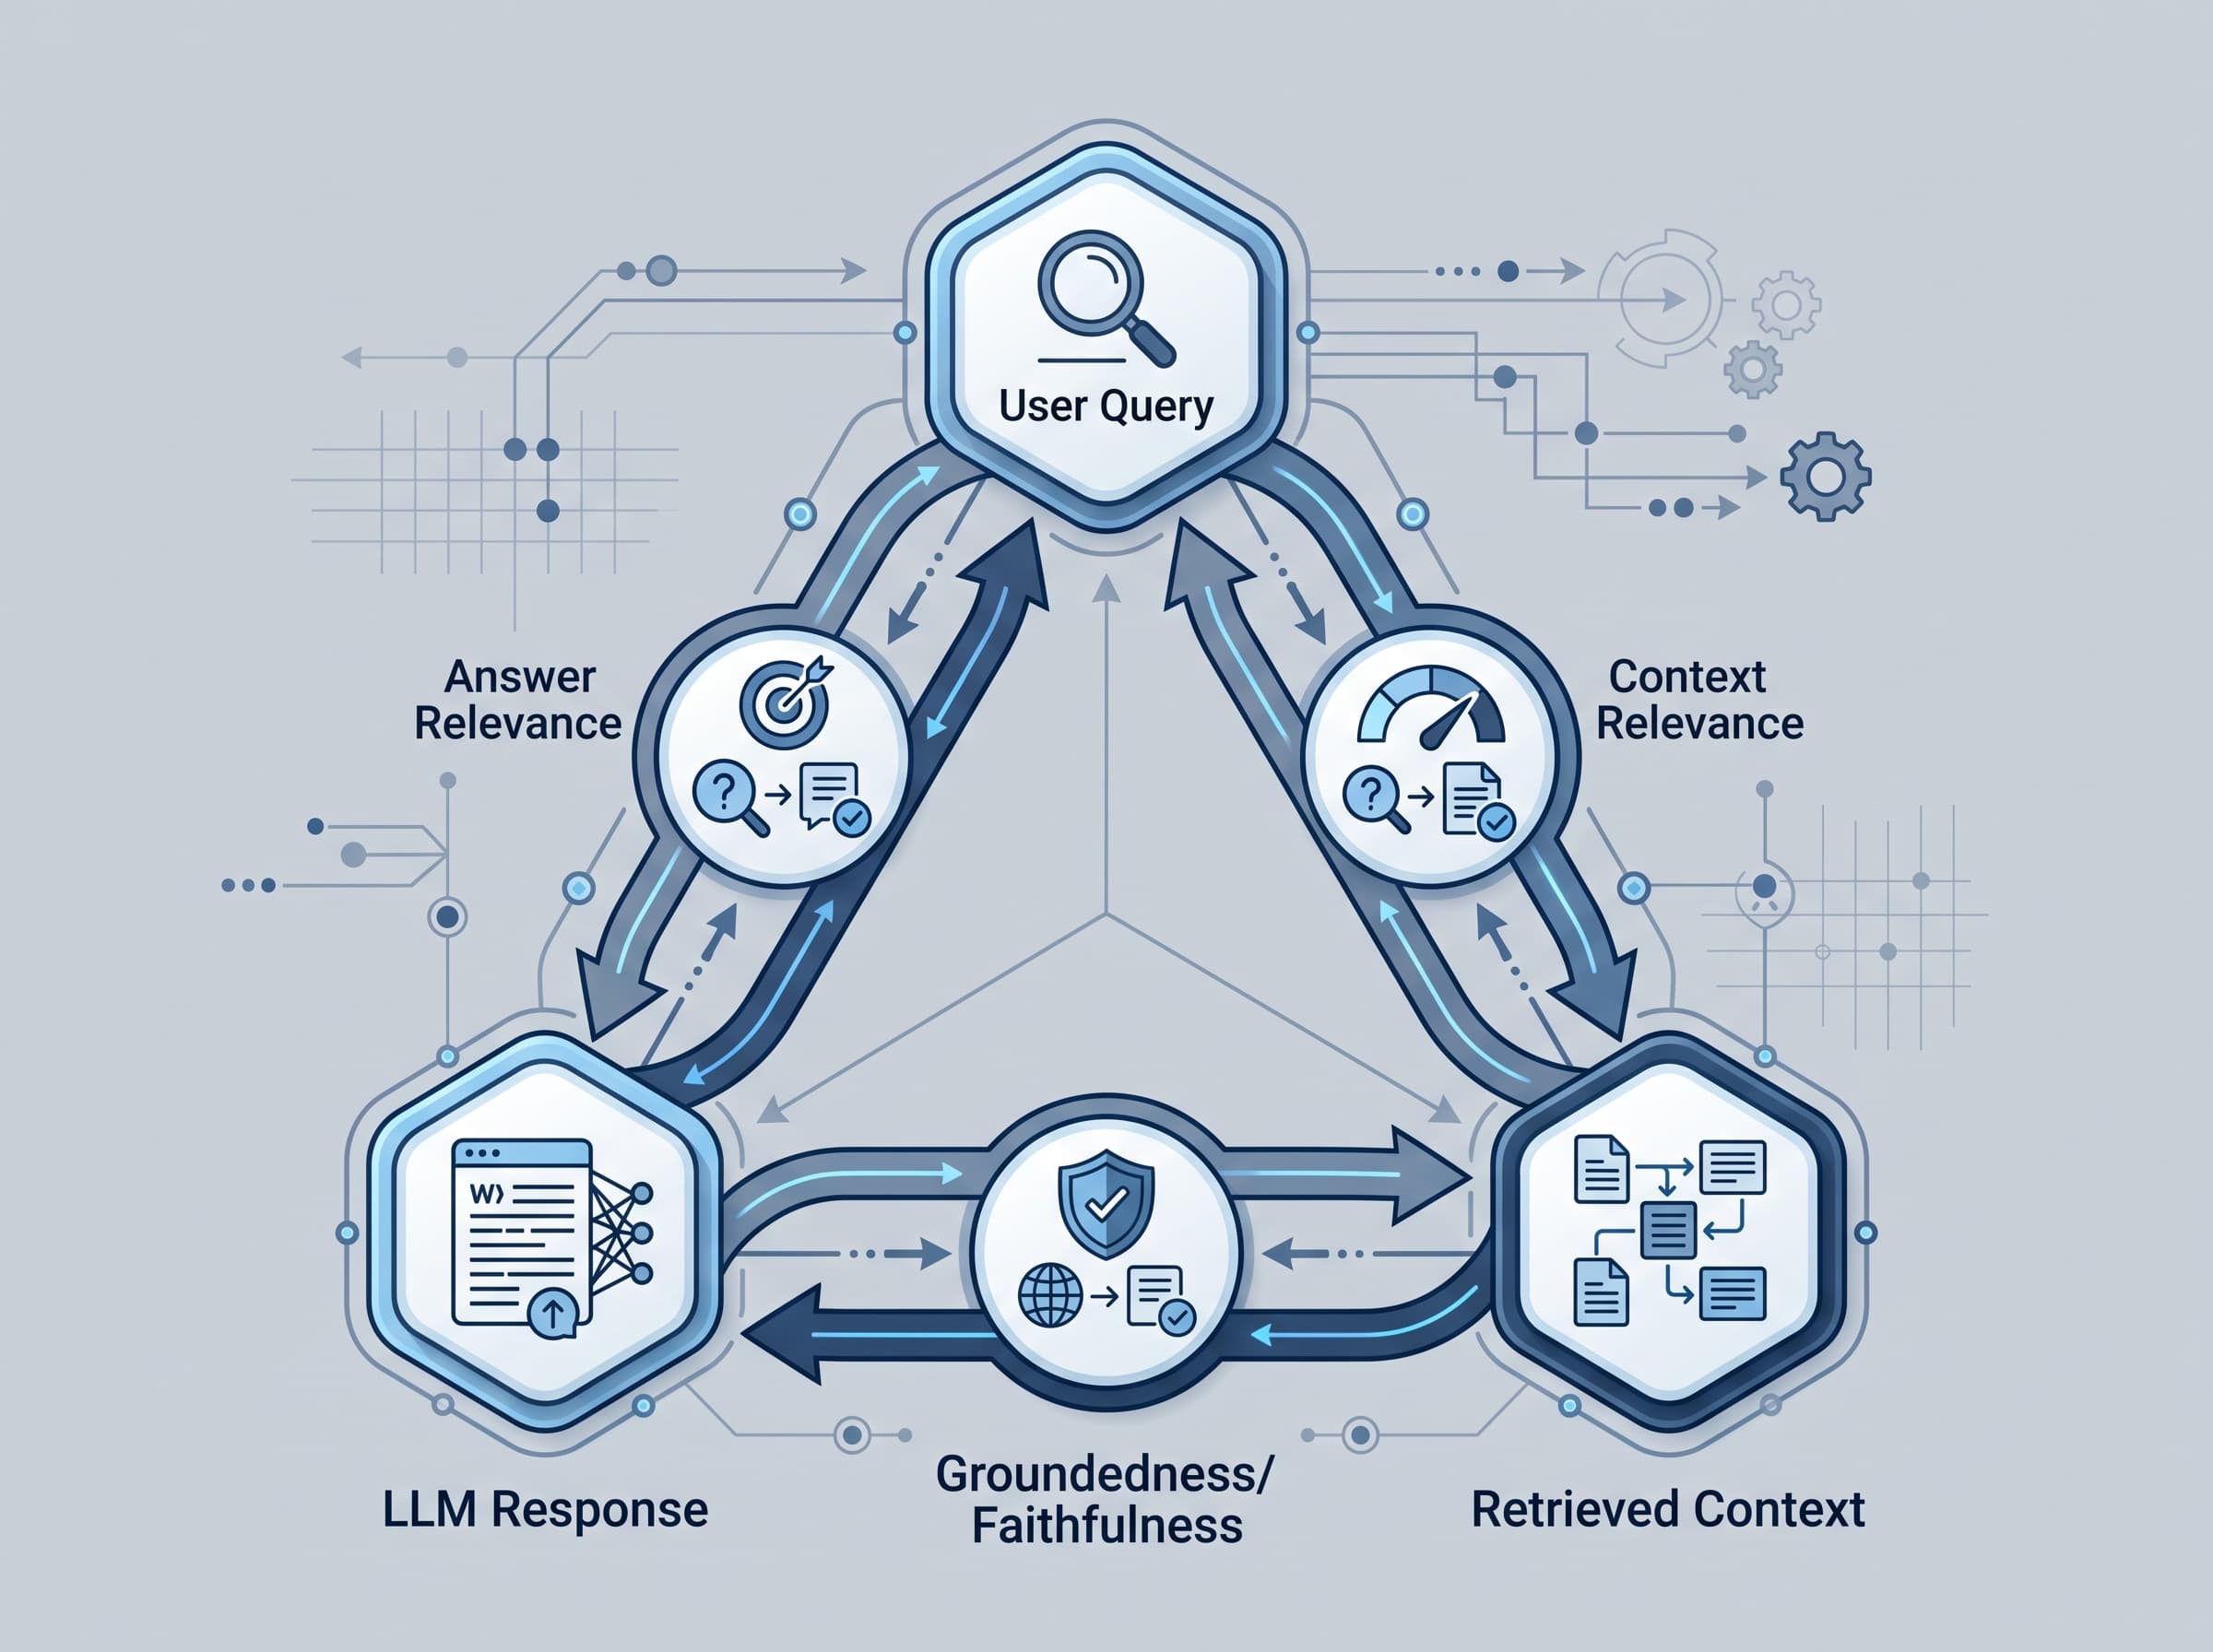
RAG 시스템을 개선할 때 '답변이 조금 더 자연스러워졌다'는 주관적인 느낌에 의존하면 특정 프롬프트 변경이 다른 질문에서 심각한 환각을 유발하는 회귀(Regression) 현상을 감지할 수 없습니다. 시스템 엔지니어링 관점에서 환각을 제어하려면 평가 도구인 TruLens가 체계화한 'RAG 트라이어드(RAG Triad)' 3대 정량 지표를 CI/CD 파이프라인에 통합해야 합니다 3. Ragas와 같은 프레임워크 역시 충실도(Faithfulness)나 문맥 정밀도(Context Precision) 등 다차원 평가 지표를 제공하지만, TruLens의 RAG 트라이어드는 사용자의 질문, 검색된 컨텍스트, 최종 답변의 세 가지 축을 기준으로 삼각 관계를 체계적으로 분리하여 환각의 원인이 검색 실패인지 생성 결함인지를 정확히 진단합니다.
첫째, 문맥 관련성(Context Relevance)은 검색기가 가져온 문서 조각들 중 질문에 실제로 필요한 정보가 얼마나 포함되어 있는지를 평가하여 검색 노이즈를 측정합니다. 둘째, 근거성(Groundedness 또는 Faithfulness)은 최종 답변에 담긴 주장이 제공된 문맥에서 논리적으로 도출되는지를 측정하여 순수 모델 환각 여부를 판정합니다 3. 셋째, 답변 관련성(Answer Relevance)은 답변이 검색 문맥에 충실한 동시에 질문자의 원래 의도에 완결성 있게 답하고 있는지를 검사합니다. 기업에서는 운영 전 대표 업무 질의-정답 세트(Golden Dataset) 200~500건을 구축하고, 모델이나 인덱싱 전략을 업데이트할 때마다 RAG 트라이어드 점수가 기준선(Baseline) 이상 유지되는지 자동 회귀 테스트를 수행해야 합니다.
6. 권한 관리(ACL)와 문서 최신성 거버넌스 체크포인트
엔터프라이즈 RAG 구축에서 기술 외적으로 답변 정확도를 훼손하는 주된 요인은 권한 격리 실패와 문서 버전 불일치입니다. 예를 들어 일반 직원이 임원용 경영 기획 문서를 열람하거나 폐기된 2021년도 출장비 규정을 바탕으로 답변을 받는다면 이는 시스템의 신뢰성을 즉각적으로 파괴합니다. 따라서 엔터프라이즈 RAG는 검색 단계 이전에 사용자 신원(ID) 및 역할 기반 접근 제어(RBAC) 또는 속성 기반 접근 제어(ABAC) 규칙을 벡터 데이터베이스의 메타데이터 필터와 강제로 동기화해야 합니다. 특히 HNSW와 같은 근사 최근접 이웃(ANN) 벡터 인덱스를 운용할 때 메타데이터 필터링 전략에 따른 트레이드오프를 면밀히 설계해야 합니다. 사후 필터링(Post-filtering)은 벡터 유사도로 Top-K 문서를 먼저 추출한 뒤 사용자의 접근 권한에 맞지 않는 문서를 걸러내는 방식인데, 만약 상위 검색 결과에 열람 권한이 없는 보안 문서가 다수 포진해 있다면 필터링 후 남는 청크 수가 극단적으로 줄어들어 검색 재현율(Recall) 누락과 심각한 문맥 결손이 발생합니다. 반대로 사전 필터링(Pre-filtering)은 사용자가 접근 가능한 문서 집합 내에서만 벡터 탐색을 진행하므로 Recall 손실을 방지하지만, 조건 필터가 지나치게 제한적이거나 복잡한 그래프 인덱스 구조일 경우 탐색 경로의 연결성이 단절되어 검색 지연시간(Latency)이 급증할 수 있습니다. 따라서 대규모 멀티테넌트 환경에서는 벡터 색인과 메타데이터 필터링을 단일 인덱스 엔진 수준에서 교차 최적화하는 단일 단계 필터링(In-filtering) 메커니즘을 적용하거나 테넌트별 파티셔닝을 사전 분기하는 아키텍처 설계가 필수적입니다.
마지막으로 사내 위키는 끊임없이 수정되고 삭제된다는 점을 간과해서는 안 됩니다. 소스 시스템(Confluence, Google Workspace 등)에서 문서가 수정되거나 삭제되었을 때 웹훅(Webhook) 또는 CDC(Change Data Capture) 파이프라인을 통해 벡터 DB의 해당 청크들을 실시간으로 무효화(Invalidation)하고 재색인하는 수명주기(TTL) 동기화 파이프라인이 필수입니다. 만약 구버전 규정과 신버전 규정이 벡터 저장소에 공존하게 되면 리랭커조차 어느 것이 현재 유효한 규정인지 판별할 수 없어 혼란을 야기합니다. 문서의 상태를 '초안(Draft)', '승인 완료(Approved)', '폐기(Deprecated)'로 메타데이터화하고 승인 완료 문서만 인덱싱 대상에 포함하는 거버넌스 규칙을 시스템적으로 확립해야 합니다.
자주 묻는 질문
Q. 벡터 임베딩 모델의 차원 수가 클수록 환각이 줄어드나요?
A. 임베딩 차원 수가 크다고 해서 환각이 자동으로 줄어들지는 않습니다. 고차원 임베딩은 복잡한 의미를 세밀하게 담아내지만 고유명사나 일련번호 매칭에는 여전히 취약합니다. 환각 감소에는 차원 수 확대보다 문맥 주석(Contextual Retrieval) 전처리, BM25와 결합한 하이브리드 검색, 그리고 교차 인코더 리랭커의 도입이 훨씬 직접적인 효과를 발휘합니다.
Q. 사내 문서가 수십만 건 이상일 때 하이브리드 검색과 리랭킹의 속도 지연은 어떻게 해결하나요?
A. 1차 하이브리드 검색에서 BM25 역색인과 HNSW 벡터 인덱스를 활용해 상위 30~50개 청크만 빠르게 필터링하고, 연산량이 큰 교차 인코더 리랭킹은 이 상위 청크에만 선별적으로 적용합니다. 예를 들어 10만~50만 건 규모의 문서 환경에서 엔비디아 A10G급 전용 GPU 인스턴스를 배치하거나 TensorRT/ONNX 런타임으로 양자화(INT8) 서빙할 경우, 리랭킹을 포함한 검색 단계 지연시간을 약 300ms 내외로 통제할 수 있습니다. 다만 이는 동시 질의 트래픽, 임베딩 차원, CPU/GPU 하드웨어 사양에 따라 크게 달라질 수 있으므로 프로덕션 요건에 맞춘 오토스케일링 및 캐싱 전략이 필수적입니다.
Q. 부서마다 사용하는 은어나 프로젝트 암호명이 많은데 어떻게 처리해야 하나요?
A. 사내 용어집(Glossary) 데이터베이스를 구축하고 사용자의 질의가 입력되었을 때 질의 확장(Query Expansion) 단계에서 이를 표준 용어로 변환하거나 동의어로 확장하는 프롬프트 또는 사전 매핑 단계를 쿼리 파이프라인 앞단에 추가해야 합니다. 또한 문맥 주석 청킹 생성 시 프로젝트 개요와 주요 약어 목록을 프롬프트 컨텍스트로 제공하여 청크 자체에 의미가 풀려 인덱싱되도록 유도하는 것이 효과적입니다.
참고 자료